Guardar de forma compacta. Usar o que precisa. Manter a origem pronta.
Um modelo de IA pode ter muitos especialistas, mesmo quando usa apenas alguns por vez. O Horizon RunMap organiza como eles são guardados, calculados e levados à GPU, a peça do computador que faz esses cálculos. Conheça a arquitetura, minhas decisões de engenharia e os resultados registrados.
Concebido e desenvolvido individualmente, com recursos limitados e sem financiamento institucional.
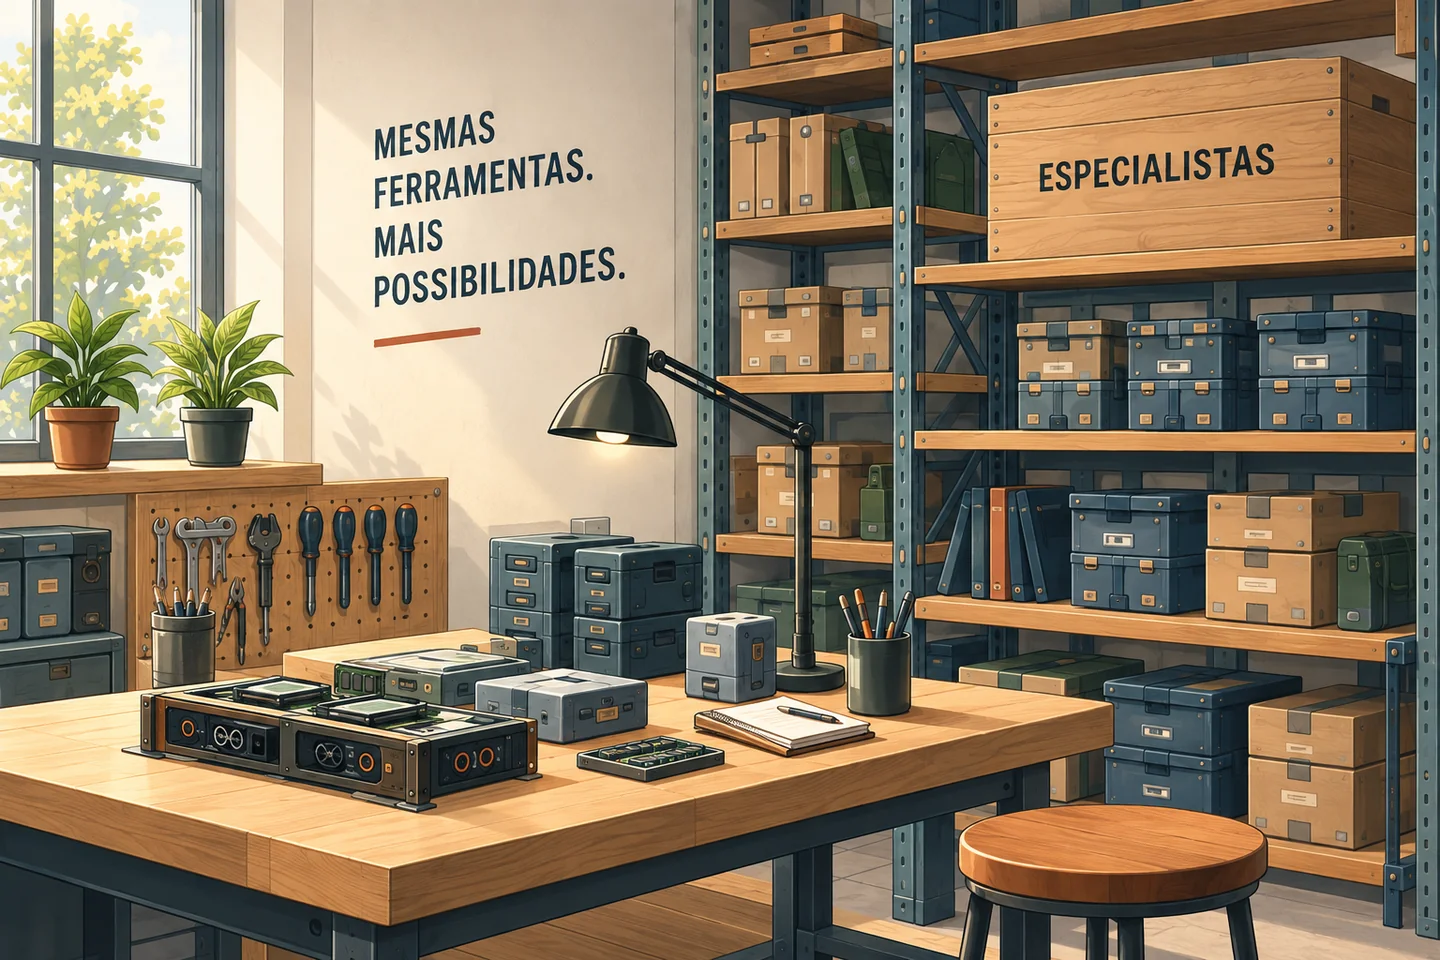
Nem tudo precisa ficar na bancada ao mesmo tempo. Uma analogia para a memória.
01 / A ideia
Primeiro, a ideia. Depois, os nomes.
A bancada
A GPU faz os cálculos. A VRAM é o espaço de memória que ela usa.
O armazém
A RAM guarda a cópia completa e imutável dos especialistas.
As ferramentas
Especialistas são partes do modelo. Cada etapa usa alguns deles.
Imagine uma oficina: a bancada tem espaço limitado e as ferramentas ficam no armazém. Aqui, cada ferramenta representa um conjunto de cálculos do modelo.
Alguns modelos de IA contêm muitos especialistas. Cada etapa usa uma seleção deles, mas o modelo completo ainda precisa de um lugar para ficar.
Por que a memória importa? Veja o contexto de modelos grandes
Em modelos MoE, uma seleção de especialistas trabalha em cada token, enquanto o conjunto completo de parâmetros precisa ser armazenado. Compare a escala em BF16 com a representação publicada pelos projetos.
A dimensão da memória
O mesmo modelo. Dois cenários de memória.
GLM-5.3744 bilhões de parâmetros totais · 40 bilhões ativos por token
Comparação em BF16
16 bits · 2 bytes por parâmetro
Memória estimada dos pesos
≈ 1,49 TB
Mínimo matemático · somente pesos
9 B200
Capacidade para planejar a execução
16 B200
2 servidores de 8 GPUs
Cenário calculado com reserva de 20%–30% da memória total e servidores completos. Contexto e carga de trabalho orientam o dimensionamento final.
Formato publicado
FP8 · 8 bits
Memória idealizada dos pesos
≈ 744 GB
Mínimo matemático · somente pesos
5 B200
Referência para execução
8 B200 · configuração documentada
A receita do vLLM descreve pesos FP8 e KV cache FP8 para contexto de até 1 milhão de tokens. A concorrência é ajustada ao orçamento de memória.
FP8 é o checkpoint padrão; a Z.ai também publica uma versão BF16 separada.
A comparação considera os pesos integralmente na memória das GPUs, com divisão ideal entre dispositivos. Pesos ≈ parâmetros totais × bits ÷ 8. Cada B200 oferece 180 GB nominais; cada servidor reúne 8 GPUs, totalizando 1,44 TB. GB e TB usam unidades decimais.
Mínimo de GPUs = pesos ÷ 180 GB, arredondado para cima. Servidores com reserva = pesos ÷ (1,44 TB × 0,80) até pesos ÷ (1,44 TB × 0,70), sempre arredondados para cima. A reserva é uma premissa de planejamento escolhida para esta comparação.
As contas usam parâmetros publicados arredondados, em vez do tamanho real dos arquivos. Escalas, tensores em precisão mista, buffers, KV cache (memória do contexto) e organização do paralelismo compõem o orçamento de execução. Quantidade de GPUs e velocidade de resposta são dimensões distintas.
Para GLM-5.3, usamos os 744 bilhões totais e 40 bilhões ativos declarados pela Z.ai. A receita do vLLM descreve aproximadamente 743/39 bilhões; essa diferença mantém o mesmo arredondamento das GPUs nesta comparação.
Os modelos de fronteira mostram a escala do desafio de memória e de infraestrutura que motiva o Horizon RunMap. OLMoE e Qwen são os modelos usados para investigar armazenamento, transferência e execução no hardware disponível. A aplicação da arquitetura a escalas maiores exige validação própria; as taxas medidas abaixo pertencem à campanha identificada.
Referências de custo por plataforma
Ofertas registradas em 10/09/2026, por plataforma ou categoria de instância. A compra e o aluguel abaixo têm escopo próprio; uma implantação com vários servidores também depende da rede e dos serviços contratados.
NVIDIA B200 (180 GB product) · fontes e estimativas registradas
NVIDIA B200 (produto de 180 GB)
Contexto externo · estimativas · Verificado em 10 de set. de 2026
Lambda: por GPU-hora, conforme a categoria
USD 6,69–6,99 / GPU-hora
Estimativa de oferta publicada
Fórmula, premissas e limites1 GPU × USD 6.69 a 6.99/GPU-hora × 1 hora
Faixa publicada pela Lambda entre categorias de instância, sem representar o menor preço de todo o mercado ou uma oferta uniforme de GPU individual.
Categoria de oito GPUs: USD 6.69 por GPU; quatro GPUs: USD 6.79 por GPU; duas GPUs: USD 6.89 por GPU; uma GPU: USD 6.99.
Região não especificada na tabela; impostos sobre vendas/IVA/GST adicionais. Nenhuma disponibilidade foi reservada.
O menor valor exige uma instância com oito GPUs. Os recursos do computador dependem da categoria; armazenamento externo, rede e operação não foram precificados aqui.
Fórmula, premissas e limites1 anunciada com oito GPUs HGX B200 plataforma × USD 390000/plataforma
Somente a oferta de pré-venda anunciada pela própria ITCT Shop; não é preço de GPU avulsa, fatura verificada ou orçamento completo de centro de dados.
A lista final de componentes e a região de entrega não foram estabelecidas. Não se afirma que CPU, RAM, armazenamento, extras do gabinete ou rede estejam incluídos.
Não há comprovação da inclusão de switches externos, cabos, eletricidade, refrigeração, trabalho operacional, frete ou impostos.
As tabelas de engenharia e afirmações publicitárias do vendedor não são usadas como evidência técnica; a especificação de capacidade vem da NVIDIA.
Esta é uma oferta atribuível, sem representar uma faixa de preços de aquisição do mercado ou uma garantia de entrega.
Capacidade de GPU, compra de plataforma, aluguel, rede, eletricidade, refrigeração e operação são planos de custo separados. Não há orçamento completo, custo total de propriedade ou recomendação de compra.
02 / A pergunta
Três decisões que trabalham juntas.
Quais pesos comprimir, como calculá-los e onde mantê-los? O Horizon trata essas decisões em conjunto. A residência completa e o offloading de especialistas são regimes dessa arquitetura.
Construí um runtime — o programa que coordena a execução do modelo — reunindo essas três decisões. Cada uma aparece abaixo com sua função e com o caminho para conhecer os detalhes.
01 / Guardar
Especialistas compactos
INT4
Os pesos dos especialistas escolhidos pelo roteamento ficam compactos na RAM e na GPU. Atenção, embeddings e os demais componentes ficam fora dessa quantização.
Kernels são as rotinas de cálculo na GPU. Os do Horizon usam os pesos compactos e convertem os valores necessários durante a operação, sem manter um especialista inteiro expandido.
Pesos compactos → kernel próprio + ativações FP16 → saída
A RAM conserva a origem completa. A GPU usa cópias de todos os especialistas ou de uma parte, conforme o espaço reservado. A origem segue pronta depois do descarte.
Residente significa guardado na memória da GPU. Nos dois casos, os especialistas usam pesos compactos INT4/qpacked e os kernels recebem ativações FP16 — os valores calculados pela etapa anterior. Cada medição identifica o executor utilizado.
Residência completa
Todos os especialistas roteados permanecem na GPU em formato compacto. Esse regime exercita a execução dos experts comprimidos, sem precisar buscar cópias ausentes durante a geração.
Memória da GPU
Residência parcial
Parte dos especialistas fica na GPU. Quando falta uma cópia solicitada, ela vem da RAM já quantizada. A remoção libera apenas a cópia na GPU; a origem em RAM continua pronta para uso futuro.
RAMOrigem completa e imutável
Área de transferênciaLimitada, no computador
Memória da GPUCópias em cache
Ver os detalhes técnicos
No fluxo de residência parcial apresentado, a origem dos especialistas na RAM permanece completa e imutável. Uma cópia passa por uma área limitada de memória fixada (pinned staging) no computador, antes da transferência para a GPU. A remoção descarta a cópia na GPU, sem transferência de volta ou regravação na origem.
Residência não é ativação: o cache pode manter especialistas que não estão sendo usados nesta etapa. O diagrama explica a organização; a campanha abaixo mede residência parcial e completa, preservando as diferenças entre executores.
Uma cópia só entra no cache quando está pronta
Arquitetura documentada · resident-qpacked-cache-v1 · ADR 0009. Escopo original: P0 Qwen experimental, desativado por padrão. Os executores medidos abaixo são descritos em seus contratos específicos.
Origem imutável
O conjunto qpacked completo permanece na RAM do processo, com identidade e layout validados.
Staging limitado
Uma área pinned temporária prepara a transferência. Ela só pode ser reutilizada após a conclusão.
Spare não publicado
A linha qpacked chega a uma posição temporária da GPU; os leitores continuam vendo a geração anterior.
Publicação atômica
Após a conclusão do grupo roteado, uma transição publica a nova geração completa do cache.
Uso e descarte
Leitores usam uma geração válida. A cópia removida só é reutilizada após a aposentadoria de seus consumidores; a origem não é reescrita.
Admissão de recursos
Capacidade é fixada antes das requisições. Se staging ou spares forem insuficientes, a inicialização rejeita o perfil; falhas anteriores à publicação preservam a geração anterior.
Perfis anteriores têm outro contrato: offload-qpacked materializa slots de execução FP16/BF16 a partir de uma fonte quantizada. No cache qpacked descrito aqui, os experts permanecem compactos. O kernel converte os valores necessários durante o cálculo, sem manter o expert inteiro expandido em um slot. Essa conversão não recupera informação perdida na quantização.
A campanha com OLMoE e Qwen em uma RTX 5070 registra execuções com residência completa e parcial. As configurações mostram como o sistema operou dentro de cada contrato de memória, executor e carga de trabalho.
A arquitetura em operação · E3 exploratório
Especialistas compactos, executados com residência completa ou parcial.
Os registros abaixo mostram modelo, espaço para cópias e executor. As taxas descrevem a geração de texto em cada configuração.
Residência completa
OLMoE 0924
O Grouped T3 executa os especialistas compactos, com todos eles na GPU durante a geração.
Maior residência medida em cada modelo · RTX 5070 · 36 respostas de 128 tokens por configuração. OLMoE e Qwen usam executores distintos; cada cartão descreve sua própria execução.
E3 exploratório
468
respostas medidas · volume da campanha
39/39execuções válidas
13configurações
1h 50min 21sduração da campanha
36 respostas de 128 tokens por configuração · 12 entradas × 3 blocos · 39 warmups excluídos das taxas.
Decode divide a soma dos tokens após o primeiro pela soma dos tempos internos de geração. É uma taxa agregada, ponderada pelo tempo. A espera pelo primeiro token e a duração da resposta são médias por requisição, com limites internos específicos de cada executor.
Decode
37min 06s
Até o primeiro token
35min 10s
Demais etapas (por diferença)
38min 05s
Amplitude relativa observada entre os blocos: 0,27%–4,78%. É variação observada, não intervalo de confiança. Temperatura máxima registrada: 58 °C.
A consolidação registrou sequências de tokens iguais entre repetições da mesma configuração. Essa observação descreve consistência dentro de cada configuração; a avaliação de qualidade e a comparação de saídas entre configurações têm escopos próprios. O tempo das demais etapas é calculado por diferença na duração do controlador.
Tokens são pequenos pedaços de texto; nem sempre palavras inteiras.
05 / Memória e velocidade
Mais espaço na bancada. O que muda?
Escolha um modelo e uma medida para explorar as configurações registradas. Cada grupo identifica o executor, o caminho de cálculo usado naquela execução.
E3 exploratório11 de set. de 2026
36 respostas por configuração · 128 tokens por resposta · 3 blocos
Hardware · NVIDIA GeForce RTX 5070, conforme o registro da campanha; computador Windows compartilhado.
Decode após o primeiro token · tokens/s Taxa agregada: Σ(tokens − 1) / Σ(tempo interno de decode). Exclui a espera pelo primeiro token; não é média das taxas individuais.
Especialistas residentes por camada · medições discretas, sem interpolação ou comparação entre modelos.
PRODUCT-core scalar
30/6423,00 tokens/s
40/6427,69 tokens/s
50/6431,50 tokens/s
60/6435,01 tokens/s
Grouped T3 · executor diferente
Entre c30–c60 (scalar) e c64 (Grouped T3), residência e executor mudam juntos. A diferença de velocidade não isola o custo do offloading nem o ganho do kernel.
64/6461,26 tokens/s
Ver as 13 configurações
A tabela contém todas as configurações. Em telas estreitas, role a tabela para os lados.
Campanha de 11/09/2026 · 36 respostas de 128 tokens por configuração · E3 exploratório NVIDIA GeForce RTX 5070 (frozen campaign declaration); shared Windows desktop. Decode = Σ(tokens − 1) / Σ(tempo interno de decode).
¹ VRAM observada pelo driver durante o worker inteiro, incluindo preparação, warmup e uso compartilhado pelo desktop. Não é VRAM exclusiva do processo ou apenas do decode.
Taxa agregada: soma dos tokens após o primeiro / soma dos tempos internos de decode. Exclui espera pelo primeiro token, preparação e aquecimento; não é a média das taxas individuais.
Modelo / revisão
allenai/OLMoE-1B-7B-0924-Instruct
Executor
PRODUCT-core scalar
Armazenamento / execução
INT4 / block 256 / FP16 scales. Valores FP16 derivados da fonte quantizada. A precisão e os valores do checkpoint original são registrados separadamente; o detalhe disponível continua limitado à representação quantizada.
Pico de RAM do processo (worker inteiro)
4,95 GiB
Transferência RAM → GPU (soma das respostas medidas)
1.108,10 GiB
Taxas dos três blocos
23,12 / 23,14 / 22,74 tokens/s
Amplitude relativa observada (não é intervalo de confiança)
1,74%
Taxa de saída incluindo espera pelo primeiro token
10,95 tokens/s
Hardware
NVIDIA GeForce RTX 5070, conforme o registro da campanha; computador Windows compartilhado.
Contrato da execução
PERF-REAL-v1; 12 entradas repetidas em 3 blocos; 36 respostas medidas de 128 tokens por configuração; seleção gulosa, EOS suprimido; aquecimento de 64 tokens excluído. Posicionamento inicial canônico, LRU evolui pelas entradas fixas; concorrência 1.
Data da execução
11 de set. de 2026
Revisão do modelo
7f1c97f440f06ce36705e4f2b843edb5925f4498
Artefato original (caminho relativo ao repositório)
Taxa agregada: soma dos tokens após o primeiro / soma dos tempos internos de decode. Exclui espera pelo primeiro token, preparação e aquecimento; não é a média das taxas individuais.
Modelo / revisão
allenai/OLMoE-1B-7B-0924-Instruct
Executor
PRODUCT-core scalar
Armazenamento / execução
INT4 / block 256 / FP16 scales. Valores FP16 derivados da fonte quantizada. A precisão e os valores do checkpoint original são registrados separadamente; o detalhe disponível continua limitado à representação quantizada.
Pico de RAM do processo (worker inteiro)
4,95 GiB
Transferência RAM → GPU (soma das respostas medidas)
576,17 GiB
Taxas dos três blocos
27,76 / 27,63 / 27,69 tokens/s
Amplitude relativa observada (não é intervalo de confiança)
0,45%
Taxa de saída incluindo espera pelo primeiro token
14,11 tokens/s
Hardware
NVIDIA GeForce RTX 5070, conforme o registro da campanha; computador Windows compartilhado.
Contrato da execução
PERF-REAL-v1; 12 entradas repetidas em 3 blocos; 36 respostas medidas de 128 tokens por configuração; seleção gulosa, EOS suprimido; aquecimento de 64 tokens excluído. Posicionamento inicial canônico, LRU evolui pelas entradas fixas; concorrência 1.
Data da execução
11 de set. de 2026
Revisão do modelo
7f1c97f440f06ce36705e4f2b843edb5925f4498
Artefato original (caminho relativo ao repositório)
Taxa agregada: soma dos tokens após o primeiro / soma dos tempos internos de decode. Exclui espera pelo primeiro token, preparação e aquecimento; não é a média das taxas individuais.
Modelo / revisão
allenai/OLMoE-1B-7B-0924-Instruct
Executor
PRODUCT-core scalar
Armazenamento / execução
INT4 / block 256 / FP16 scales. Valores FP16 derivados da fonte quantizada. A precisão e os valores do checkpoint original são registrados separadamente; o detalhe disponível continua limitado à representação quantizada.
Pico de RAM do processo (worker inteiro)
4,95 GiB
Transferência RAM → GPU (soma das respostas medidas)
230,88 GiB
Taxas dos três blocos
31,75 / 31,57 / 31,19 tokens/s
Amplitude relativa observada (não é intervalo de confiança)
1,75%
Taxa de saída incluindo espera pelo primeiro token
16,73 tokens/s
Hardware
NVIDIA GeForce RTX 5070, conforme o registro da campanha; computador Windows compartilhado.
Contrato da execução
PERF-REAL-v1; 12 entradas repetidas em 3 blocos; 36 respostas medidas de 128 tokens por configuração; seleção gulosa, EOS suprimido; aquecimento de 64 tokens excluído. Posicionamento inicial canônico, LRU evolui pelas entradas fixas; concorrência 1.
Data da execução
11 de set. de 2026
Revisão do modelo
7f1c97f440f06ce36705e4f2b843edb5925f4498
Artefato original (caminho relativo ao repositório)
Taxa agregada: soma dos tokens após o primeiro / soma dos tempos internos de decode. Exclui espera pelo primeiro token, preparação e aquecimento; não é a média das taxas individuais.
Modelo / revisão
allenai/OLMoE-1B-7B-0924-Instruct
Executor
PRODUCT-core scalar
Armazenamento / execução
INT4 / block 256 / FP16 scales. Valores FP16 derivados da fonte quantizada. A precisão e os valores do checkpoint original são registrados separadamente; o detalhe disponível continua limitado à representação quantizada.
Pico de RAM do processo (worker inteiro)
4,96 GiB
Transferência RAM → GPU (soma das respostas medidas)
37,62 GiB
Taxas dos três blocos
35,47 / 34,72 / 34,85 tokens/s
Amplitude relativa observada (não é intervalo de confiança)
2,14%
Taxa de saída incluindo espera pelo primeiro token
19,31 tokens/s
Hardware
NVIDIA GeForce RTX 5070, conforme o registro da campanha; computador Windows compartilhado.
Contrato da execução
PERF-REAL-v1; 12 entradas repetidas em 3 blocos; 36 respostas medidas de 128 tokens por configuração; seleção gulosa, EOS suprimido; aquecimento de 64 tokens excluído. Posicionamento inicial canônico, LRU evolui pelas entradas fixas; concorrência 1.
Data da execução
11 de set. de 2026
Revisão do modelo
7f1c97f440f06ce36705e4f2b843edb5925f4498
Artefato original (caminho relativo ao repositório)
Extrato da campanha com identificadores e textos originais em inglês. O pacote completo e as observações brutas têm disponibilidade própria.
OLMoE 0924 · 64/64 · Grouped T3 — contrato e medidas adicionais
Métrica
Taxa agregada: soma dos tokens após o primeiro / soma dos tempos internos de decode. Exclui espera pelo primeiro token, preparação e aquecimento; não é a média das taxas individuais.
Modelo / revisão
allenai/OLMoE-1B-7B-0924-Instruct
Executor
Grouped T3
Armazenamento / execução
INT4 / block 256 / FP16 scales. Valores FP16 derivados da fonte quantizada. A precisão e os valores do checkpoint original são registrados separadamente; o detalhe disponível continua limitado à representação quantizada.
Pico de RAM do processo (worker inteiro)
4,98 GiB
Transferência RAM → GPU (soma das respostas medidas)
0,00 GiB
Taxas dos três blocos
59,72 / 62,65 / 61,47 tokens/s
Amplitude relativa observada (não é intervalo de confiança)
4,78%
Taxa de saída incluindo espera pelo primeiro token
45,41 tokens/s
Hardware
NVIDIA GeForce RTX 5070, conforme o registro da campanha; computador Windows compartilhado.
Contrato da execução
PERF-REAL-v1; 12 entradas repetidas em 3 blocos; 36 respostas medidas de 128 tokens por configuração; seleção gulosa, EOS suprimido; aquecimento de 64 tokens excluído. Posicionamento inicial canônico, LRU evolui pelas entradas fixas; concorrência 1.
Data da execução
11 de set. de 2026
Revisão do modelo
7f1c97f440f06ce36705e4f2b843edb5925f4498
Artefato original (caminho relativo ao repositório)
Taxa agregada: soma dos tokens após o primeiro / soma dos tempos internos de decode. Exclui espera pelo primeiro token, preparação e aquecimento; não é a média das taxas individuais.
Modelo / revisão
allenai/OLMoE-1B-7B-0125-Instruct
Executor
PRODUCT-core scalar
Armazenamento / execução
INT4 / block 256 / FP16 scales. Valores FP16 derivados da fonte quantizada. A precisão e os valores do checkpoint original são registrados separadamente; o detalhe disponível continua limitado à representação quantizada.
Pico de RAM do processo (worker inteiro)
4,97 GiB
Transferência RAM → GPU (soma das respostas medidas)
1.115,87 GiB
Taxas dos três blocos
22,65 / 22,98 / 23,51 tokens/s
Amplitude relativa observada (não é intervalo de confiança)
3,74%
Taxa de saída incluindo espera pelo primeiro token
11,05 tokens/s
Hardware
NVIDIA GeForce RTX 5070, conforme o registro da campanha; computador Windows compartilhado.
Contrato da execução
PERF-REAL-v1; 12 entradas repetidas em 3 blocos; 36 respostas medidas de 128 tokens por configuração; seleção gulosa, EOS suprimido; aquecimento de 64 tokens excluído. Posicionamento inicial canônico, LRU evolui pelas entradas fixas; concorrência 1.
Data da execução
11 de set. de 2026
Revisão do modelo
b89a7c4bc24fb9e55ce2543c9458ce0ca5c4650e
Artefato original (caminho relativo ao repositório)
Taxa agregada: soma dos tokens após o primeiro / soma dos tempos internos de decode. Exclui espera pelo primeiro token, preparação e aquecimento; não é a média das taxas individuais.
Modelo / revisão
allenai/OLMoE-1B-7B-0125-Instruct
Executor
PRODUCT-core scalar
Armazenamento / execução
INT4 / block 256 / FP16 scales. Valores FP16 derivados da fonte quantizada. A precisão e os valores do checkpoint original são registrados separadamente; o detalhe disponível continua limitado à representação quantizada.
Pico de RAM do processo (worker inteiro)
4,95 GiB
Transferência RAM → GPU (soma das respostas medidas)
580,72 GiB
Taxas dos três blocos
27,21 / 26,75 / 27,42 tokens/s
Amplitude relativa observada (não é intervalo de confiança)
2,47%
Taxa de saída incluindo espera pelo primeiro token
13,90 tokens/s
Hardware
NVIDIA GeForce RTX 5070, conforme o registro da campanha; computador Windows compartilhado.
Contrato da execução
PERF-REAL-v1; 12 entradas repetidas em 3 blocos; 36 respostas medidas de 128 tokens por configuração; seleção gulosa, EOS suprimido; aquecimento de 64 tokens excluído. Posicionamento inicial canônico, LRU evolui pelas entradas fixas; concorrência 1.
Data da execução
11 de set. de 2026
Revisão do modelo
b89a7c4bc24fb9e55ce2543c9458ce0ca5c4650e
Artefato original (caminho relativo ao repositório)
Taxa agregada: soma dos tokens após o primeiro / soma dos tempos internos de decode. Exclui espera pelo primeiro token, preparação e aquecimento; não é a média das taxas individuais.
Modelo / revisão
allenai/OLMoE-1B-7B-0125-Instruct
Executor
PRODUCT-core scalar
Armazenamento / execução
INT4 / block 256 / FP16 scales. Valores FP16 derivados da fonte quantizada. A precisão e os valores do checkpoint original são registrados separadamente; o detalhe disponível continua limitado à representação quantizada.
Pico de RAM do processo (worker inteiro)
4,95 GiB
Transferência RAM → GPU (soma das respostas medidas)
235,35 GiB
Taxas dos três blocos
31,10 / 31,31 / 31,25 tokens/s
Amplitude relativa observada (não é intervalo de confiança)
0,66%
Taxa de saída incluindo espera pelo primeiro token
16,71 tokens/s
Hardware
NVIDIA GeForce RTX 5070, conforme o registro da campanha; computador Windows compartilhado.
Contrato da execução
PERF-REAL-v1; 12 entradas repetidas em 3 blocos; 36 respostas medidas de 128 tokens por configuração; seleção gulosa, EOS suprimido; aquecimento de 64 tokens excluído. Posicionamento inicial canônico, LRU evolui pelas entradas fixas; concorrência 1.
Data da execução
11 de set. de 2026
Revisão do modelo
b89a7c4bc24fb9e55ce2543c9458ce0ca5c4650e
Artefato original (caminho relativo ao repositório)
Taxa agregada: soma dos tokens após o primeiro / soma dos tempos internos de decode. Exclui espera pelo primeiro token, preparação e aquecimento; não é a média das taxas individuais.
Modelo / revisão
allenai/OLMoE-1B-7B-0125-Instruct
Executor
PRODUCT-core scalar
Armazenamento / execução
INT4 / block 256 / FP16 scales. Valores FP16 derivados da fonte quantizada. A precisão e os valores do checkpoint original são registrados separadamente; o detalhe disponível continua limitado à representação quantizada.
Pico de RAM do processo (worker inteiro)
4,96 GiB
Transferência RAM → GPU (soma das respostas medidas)
40,81 GiB
Taxas dos três blocos
35,45 / 35,49 / 35,39 tokens/s
Amplitude relativa observada (não é intervalo de confiança)
0,27%
Taxa de saída incluindo espera pelo primeiro token
19,54 tokens/s
Hardware
NVIDIA GeForce RTX 5070, conforme o registro da campanha; computador Windows compartilhado.
Contrato da execução
PERF-REAL-v1; 12 entradas repetidas em 3 blocos; 36 respostas medidas de 128 tokens por configuração; seleção gulosa, EOS suprimido; aquecimento de 64 tokens excluído. Posicionamento inicial canônico, LRU evolui pelas entradas fixas; concorrência 1.
Data da execução
11 de set. de 2026
Revisão do modelo
b89a7c4bc24fb9e55ce2543c9458ce0ca5c4650e
Artefato original (caminho relativo ao repositório)
Extrato da campanha com identificadores e textos originais em inglês. O pacote completo e as observações brutas têm disponibilidade própria.
OLMoE 0125 · 64/64 · Grouped T3 — contrato e medidas adicionais
Métrica
Taxa agregada: soma dos tokens após o primeiro / soma dos tempos internos de decode. Exclui espera pelo primeiro token, preparação e aquecimento; não é a média das taxas individuais.
Modelo / revisão
allenai/OLMoE-1B-7B-0125-Instruct
Executor
Grouped T3
Armazenamento / execução
INT4 / block 256 / FP16 scales. Valores FP16 derivados da fonte quantizada. A precisão e os valores do checkpoint original são registrados separadamente; o detalhe disponível continua limitado à representação quantizada.
Pico de RAM do processo (worker inteiro)
4,96 GiB
Transferência RAM → GPU (soma das respostas medidas)
0,00 GiB
Taxas dos três blocos
62,69 / 61,39 / 62,15 tokens/s
Amplitude relativa observada (não é intervalo de confiança)
2,10%
Taxa de saída incluindo espera pelo primeiro token
46,67 tokens/s
Hardware
NVIDIA GeForce RTX 5070, conforme o registro da campanha; computador Windows compartilhado.
Contrato da execução
PERF-REAL-v1; 12 entradas repetidas em 3 blocos; 36 respostas medidas de 128 tokens por configuração; seleção gulosa, EOS suprimido; aquecimento de 64 tokens excluído. Posicionamento inicial canônico, LRU evolui pelas entradas fixas; concorrência 1.
Data da execução
11 de set. de 2026
Revisão do modelo
b89a7c4bc24fb9e55ce2543c9458ce0ca5c4650e
Artefato original (caminho relativo ao repositório)
Extrato da campanha com identificadores e textos originais em inglês. O pacote completo e as observações brutas têm disponibilidade própria.
Qwen · 20/60 · top4-fused-v1 — contrato e medidas adicionais
Métrica
Taxa agregada: soma dos tokens após o primeiro / soma dos tempos internos de decode. Exclui espera pelo primeiro token, preparação e aquecimento; não é a média das taxas individuais.
Modelo / revisão
Qwen/Qwen1.5-MoE-A2.7B-Chat
Executor
top4-fused-v1
Armazenamento / execução
INT4 / block 256 / FP16 scales. Valores FP16 derivados da fonte quantizada. A precisão e os valores do checkpoint original são registrados separadamente; o detalhe disponível continua limitado à representação quantizada.
Pico de RAM do processo (worker inteiro)
7,97 GiB
Transferência RAM → GPU (soma das respostas medidas)
2.702,75 GiB
Taxas dos três blocos
15,08 / 15,03 / 15,56 tokens/s
Amplitude relativa observada (não é intervalo de confiança)
3,49%
Taxa de saída incluindo espera pelo primeiro token
7,21 tokens/s
Hardware
NVIDIA GeForce RTX 5070, conforme o registro da campanha; computador Windows compartilhado.
Contrato da execução
PERF-REAL-v1; 12 entradas repetidas em 3 blocos; 36 respostas medidas de 128 tokens por configuração; seleção gulosa, EOS suprimido; aquecimento de 64 tokens excluído. Posicionamento inicial canônico, LRU evolui pelas entradas fixas; concorrência 1.
Data da execução
11 de set. de 2026
Revisão do modelo
ec052fda178e241c7c443468d2fa1db6618996be
Artefato original (caminho relativo ao repositório)
Extrato da campanha com identificadores e textos originais em inglês. O pacote completo e as observações brutas têm disponibilidade própria.
Qwen · 30/60 · top4-fused-v1 — contrato e medidas adicionais
Métrica
Taxa agregada: soma dos tokens após o primeiro / soma dos tempos internos de decode. Exclui espera pelo primeiro token, preparação e aquecimento; não é a média das taxas individuais.
Modelo / revisão
Qwen/Qwen1.5-MoE-A2.7B-Chat
Executor
top4-fused-v1
Armazenamento / execução
INT4 / block 256 / FP16 scales. Valores FP16 derivados da fonte quantizada. A precisão e os valores do checkpoint original são registrados separadamente; o detalhe disponível continua limitado à representação quantizada.
Pico de RAM do processo (worker inteiro)
7,99 GiB
Transferência RAM → GPU (soma das respostas medidas)
1.852,07 GiB
Taxas dos três blocos
17,45 / 17,02 / 17,04 tokens/s
Amplitude relativa observada (não é intervalo de confiança)
2,51%
Taxa de saída incluindo espera pelo primeiro token
8,59 tokens/s
Hardware
NVIDIA GeForce RTX 5070, conforme o registro da campanha; computador Windows compartilhado.
Contrato da execução
PERF-REAL-v1; 12 entradas repetidas em 3 blocos; 36 respostas medidas de 128 tokens por configuração; seleção gulosa, EOS suprimido; aquecimento de 64 tokens excluído. Posicionamento inicial canônico, LRU evolui pelas entradas fixas; concorrência 1.
Data da execução
11 de set. de 2026
Revisão do modelo
ec052fda178e241c7c443468d2fa1db6618996be
Artefato original (caminho relativo ao repositório)
Extrato da campanha com identificadores e textos originais em inglês. O pacote completo e as observações brutas têm disponibilidade própria.
Qwen · 39/60 · top4-fused-v1 — contrato e medidas adicionais
Métrica
Taxa agregada: soma dos tokens após o primeiro / soma dos tempos internos de decode. Exclui espera pelo primeiro token, preparação e aquecimento; não é a média das taxas individuais.
Modelo / revisão
Qwen/Qwen1.5-MoE-A2.7B-Chat
Executor
top4-fused-v1
Armazenamento / execução
INT4 / block 256 / FP16 scales. Valores FP16 derivados da fonte quantizada. A precisão e os valores do checkpoint original são registrados separadamente; o detalhe disponível continua limitado à representação quantizada.
Pico de RAM do processo (worker inteiro)
7,97 GiB
Transferência RAM → GPU (soma das respostas medidas)
1.172,50 GiB
Taxas dos três blocos
20,31 / 19,78 / 19,76 tokens/s
Amplitude relativa observada (não é intervalo de confiança)
2,74%
Taxa de saída incluindo espera pelo primeiro token
10,52 tokens/s
Hardware
NVIDIA GeForce RTX 5070, conforme o registro da campanha; computador Windows compartilhado.
Contrato da execução
PERF-REAL-v1; 12 entradas repetidas em 3 blocos; 36 respostas medidas de 128 tokens por configuração; seleção gulosa, EOS suprimido; aquecimento de 64 tokens excluído. Posicionamento inicial canônico, LRU evolui pelas entradas fixas; concorrência 1.
Data da execução
11 de set. de 2026
Revisão do modelo
ec052fda178e241c7c443468d2fa1db6618996be
Artefato original (caminho relativo ao repositório)
Extrato da campanha com identificadores e textos originais em inglês. O pacote completo e as observações brutas têm disponibilidade própria.
06 / Acompanhe um token
Um pedaço de texto. Uma sequência de decisões.
Tokens são pequenos pedaços de texto. O modelo os processa em camadas; o roteamento escolhe os especialistas que participam de cada etapa. O runtime coordena os recursos que tornam essa execução possível.
Da entrada à resposta: acompanhe como o trabalho se organiza. O diagrama seguinte mostra o que acontece com as cópias dos especialistas. Ver acerto, falta e descarte
Ler a entrada
O texto é dividido em tokens e processado pelo modelo.
Selecionar especialistas
O roteamento escolhe especialistas em cada camada roteada.
Consultar o cache
Se a cópia está na GPU, ela pode ser usada. Se falta, vem da RAM pela área de transferência.
Produzir o próximo token
Os cálculos das camadas contribuem para a próxima saída. O processo se repete.
07 / De volta à oficina
O armazém continua intacto.
O armazém guarda o conjunto completo dos especialistas. A bancada usa cópias. Veja três situações de um mesmo mecanismo: o cache, que mantém cópias prontas na memória da GPU.
Uma origem completa. Cópias para trabalhar.
Em todas as situações, os especialistas compactos continuam guardados na RAM. Essa é a origem imutável.
Acerto
Usar a cópia pronta
RAMOrigem intacta
Já está na GPU
GPUCópia disponível
O especialista solicitado já tem uma cópia pronta na bancada. O cálculo usa essa cópia.
A origem fica intacta; essa consulta dispensa uma nova transferência do especialista.
Falta
Trazer uma cópia
RAMOrigem intacta
Copiar para a GPU
GPUCópia recebida
A cópia solicitada vem da RAM pela área de transferência. Ela fica disponível para uso quando a transferência termina e o novo estado completo do cache é publicado.
A origem permanece pronta na RAM, inclusive depois da transferência.
Descarte
Liberar espaço
RAMOrigem intacta
Liberar na GPU
GPUCópia liberada
Quando pode ser liberada com segurança, a cópia sai da bancada. A posição só é reutilizada depois que os cálculos que usam essa cópia terminam.
A origem segue pronta para uma próxima cópia; os pesos não precisam voltar à CPU.
Três situações possíveis, não uma sequência obrigatória. O desenho explica o mecanismo; quantidades e tempos são informados nos resultados de cada configuração.Conhecer a transferência e a publicação do cache →
08 / Precisão e qualidade
Precisão também é uma decisão de engenharia.
Na arquitetura qpacked apresentada, os pesos dos especialistas roteados permanecem compactos em INT4 na RAM e na GPU. Os kernels usam ativações FP16: W4A16 descreve esses dois formatos. Os demais componentes do modelo ficam fora dessa quantização INT4.
O formato guardado, o formato usado durante o cálculo e a precisão da soma são decisões distintas. Os pesos compactos são convertidos dentro do kernel conforme o cálculo precisa deles; o especialista inteiro não ocupa um slot permanente expandido.
Guardar
W4: pesos dos experts roteados em INT4, com escalas FP16. O cache da GPU conserva esse formato compacto.
Calcular
A16: ativações FP16. Os kernels convertem pesos durante o cálculo e têm etapas de acumulação FP32 e arredondamentos explícitos. W4A16 não descreve sozinho toda a aritmética.
Demais componentes
Atenção, embeddings, roteamento e demais componentes ficam fora do INT4. Na campanha, os pesos não roteados são materializados em FP16 a partir do checkpoint BF16.
09 / Trabalhos relacionados
Diferentes maneiras de compartilhar a memória.
O Horizon faz parte de um campo mais amplo de organização da memória. Estes projetos movimentam unidades diferentes de trabalho, usam a CPU de formas distintas e atendem a cargas diferentes.
Este mapa compara decisões de arquitetura: o que cada projeto armazena, movimenta e calcula. Uma comparação de desempenho entre runtimes exige um experimento próprio com checkpoint, precisão, hardware e carga de trabalho comparáveis.
HHorizon RunMapEspecialistas compactos e cópias sob controle
Residência
Residência parcial ou completa, conforme configuração e executor. As quantidades da campanha são por camada.
Precisão de armazenamento
O perfil resident-qpacked-cache-v1 documenta a origem em RAM e o cache na GPU em formato qpacked, com caminho W4A16. O offload-qpacked usa slots FP16/BF16 reconstruídos da fonte de baixa precisão; são mecanismos distintos.
Papel da CPU
No cache imutável documentado, a CPU mantém a origem completa em RAM e coordena staging, admissão e publicação. Esse é o papel arquitetural da CPU; sua utilização é uma métrica separada.
Unidade de movimentação
Linhas de especialistas roteados, por camada; áreas temporárias limitadas para transporte.
Política de distribuição
Capacidade de cache fixada antes da admissão. Especialistas residentes não são necessariamente os ativos no token atual.
Estratégia de sobreposição
O ADR 0009 serializa transações de miss e só publica após conclusão. A contribuição descrita aqui é a coordenação da transferência e da publicação.
Classe de hardware
A campanha selecionada declara uma RTX 5070 em computador Windows compartilhado. Esse hardware define o contexto das capacidades registradas.
Carga de trabalho divulgada
OLMoE 0924, OLMoE 0125 e Qwen; 13 configurações, 12 entradas repetidas em três blocos, 128 tokens por resposta medida.
Maturidade das medições
Resultados E3 exploratórios de memória e execução. OLMoE c64 também muda o executor; os limites gerais estão na seção de escopo da pesquisa.
Mecanismos documentados e escopo medido são identificados separadamente. O ADR 0009 não autoriza generalizar seu perfil P0 para todos os braços desta campanha.
Esta apresentação reúne a arquitetura, as decisões de engenharia e uma campanha de testes com OLMoE e Qwen em computador compartilhado. Os resultados têm nível E3 exploratório: registram memória, transferências e tempos nas configurações informadas.
A qualidade das respostas ainda não foi avaliada. Sequências mais longas, crescimento da memória de contexto (KV cache), outros modelos e equipamentos, uso em produção e identificação causal de gargalos exigem investigações próprias. Esses são os limites das conclusões desta campanha.
Perguntas para ler a pesquisa
Como interpretar os resultados?
As taxas registram como o Horizon operou nas configurações publicadas. Uma comparação de desempenho com outro runtime é uma pergunta de pesquisa própria: exige checkpoint, precisão, hardware, entradas e geração comparáveis.
Quais dados explicam o cache?
H2D é o volume transferido do computador para a GPU. O explorador apresenta o total registrado nas respostas medidas. Acertos, faltas e custo por falta exigem contadores e tempos próprios; esse volume sozinho não determina essas medidas.
O que posso verificar nos downloads?
Os arquivos permitem conferir integridade e consistência entre os dados publicados. Reproduzir o experimento completo exige também código, ambiente e observações brutas suficientes. O bloco de auditoria descreve o material compartilhado e a disponibilidade do código.
Esta página reúne OLMoE 0924, OLMoE 0125 e Qwen. Cada configuração usa 12 entradas em três blocos, com respostas de 128 tokens.
Verificações curtas e séries históricas usam condições diferentes e ficam separadas desta campanha. Cada conjunto de arquivos identifica suas condições de execução.
Desconhecido (UNKNOWN) significa informação ausente ou não medida. Não suportado (UNSUPPORTED) significa que a plataforma ou dependência não oferece a observação.
Da pergunta ao runtime: as escolhas de quem constrói.
Concebi e desenvolvo o Horizon individualmente, conectando pesquisa, implementação e análise dos resultados. Trabalhar com recursos limitados exige escolher o que construir, como verificar cada decisão e onde concentrar o próximo esforço.
A trajetória parte da pesquisa do NeuronMap e evolui em um runtime próprio, com a procedência do código reutilizado registrada. As decisões abaixo mostram essa direção de engenharia; os contratos da campanha identificam as configurações efetivamente medidas.
01
A memória é um orçamento
Problema · Uma etapa ativa poucos especialistas, mas o conjunto de pesos precisa continuar acessível.
Decisão de engenharia · Distinguir armazenamento, residência e execução; declarar a capacidade por camada e por perfil.
Como interpretar · Essa decisão torna explícito quanto espaço cada configuração reserva para os especialistas.
Problema · Substituir uma cópia em uso exige preservar a autoridade dos pesos e dos leitores do cache.
Decisão de engenharia · Manter a origem em RAM imutável, preparar as novas cópias em posições temporárias da GPU e tornar o novo estado do cache visível de uma só vez, após a transferência.
Como interpretar · Os cálculos recebem um conjunto completo de cópias prontas para uso, enquanto a origem em RAM permanece intacta.
Problema · No OLMoE, c60 e c64 mudam residência e executor ao mesmo tempo.
Decisão de engenharia · Manter os resultados disponíveis, separar o ponto Grouped T3 e explicitar o contrato ao lado da medição.
Como interpretar · A leitura considera as duas mudanças em conjunto. As taxas dos três blocos mostram a variação registrada; isolar o efeito causal da residência requer outro desenho experimental.
Esta é a apresentação da pesquisa: arquitetura, decisões técnicas e registros de execução do Horizon.
12 / Contato
Conheça quem está construindo o Horizon.
O projeto reúne o trabalho que quero levar a novas oportunidades: investigar problemas de sistemas de IA, construir soluções e avaliar resultados. Estou aberto a conversas técnicas, colaboração e oportunidades profissionais.
Lucas Ribeiro
Criador do Horizon RunMap · pesquisa independente
Uma pessoa conectando pesquisa, engenharia e experimentação.
Sou Lucas Ribeiro. Concebi e desenvolvo o Horizon individualmente, com recursos limitados e sem financiamento institucional. O projeto reúne meu trabalho de investigação, construção do runtime e análise dos experimentos.
Quero levar essa capacidade de construir e investigar a desafios de sistemas de IA, em colaboração com pessoas e organizações que valorizem engenharia cuidadosa e iniciativa.
Esta edição reúne extratos curados da campanha já realizada. Você pode conferir a integridade dos arquivos e a consistência entre cada extrato e o conjunto de agregados.
Siga o guia para baixar o manifesto e seus 19 arquivos em uma pasta nova, mantendo os nomes. Há um comando PowerShell para baixar a edição completa.
Com Node.js 22.19.0, execute dentro dessa pasta:
node verify-evidence-edition.mjs --directory .
PASS confirma os hashes de 19 arquivos e a concordância das 13 cópias de agregados. O verificador usa apenas arquivos locais, sem instalar dependências ou executar modelos.
A verificação cobre a integridade dos arquivos e a consistência dos agregados desta edição. A reprodução do experimento e o recálculo a partir de observações brutas exigem o material completo e um procedimento próprio. Os hashes conferem os arquivos contra o manifesto fornecido; a autenticação do publicador é uma verificação distinta.
O código do runtime permanece privado por decisão do autor. Esta apresentação compartilha a arquitetura, as decisões de engenharia e os resultados documentados. Os downloads incluem extratos, relatório, notas técnicas e verificador.